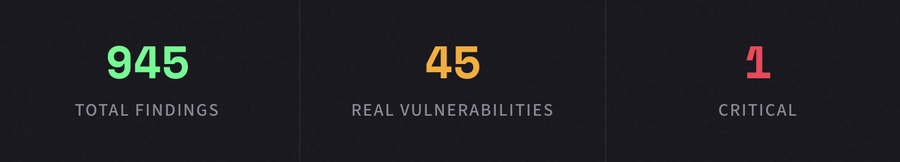
945 wykrytych zagrożeń. 900 z nich to fałszywe alarmy. 45 to rzeczywiste zagrożenia. 1 miało charakter krytyczny. Tak właśnie wygląda bezpieczeństwo kodu opartego na sztucznej inteligencji.
Tradycyjne narzędzia do analizy statycznej zostały stworzone z myślą o świecie, w którym to ludzie piszą każdą linię kodu. Porównują one kod z znanymi sygnaturami luk w zabezpieczeniach, wskazują setki potencjalnych problemów, a następnie pozostawiają zespołowi zadanie oddzielenia istotnych informacji od szumu.
Ten model się załamuje. I to szybko.
Wraz z rozwojem programowania wspomaganego przez sztuczną inteligencję — zjawiska, które w branży zaczęto nazywać „vibe coding” — kod jest generowany szybciej, niż jakikolwiek zespół ludzki jest w stanie go ręcznie sprawdzić. Asystenci programistyczni, generatory kodu i agenci AI wprowadzają funkcje w ciągu kilku minut, co wcześniej zajmowało całe dni. Tempo jest niezwykłe. Ale ryzyko też jest ogromne.
Bo nawet kod, który sam się pisze, wciąż potrzebuje kogoś, kto będzie go pilnował.
Skanowanie OpenClaw
Wykorzystaliśmy narzędzie CyberTested Code do analizy OpenClaw – publicznie dostępnego repozytorium kodu open source – aby poddać nasz silnik testom obciążeniowym w warunkach rzeczywistego projektu. Żadnych syntetycznych testów porównawczych. Żadnych starannie dobranych repozytoriów. Tylko surowy kod, analizowany od początku do końca.
Wyniki były jednoznaczne: nasz silnik wykrył 945 wyników w całym kodzie źródłowym. Spośród nich około 900 stanowiły fałszywe alarmy — czyli alerty o niskim poziomie pewności i pozbawione kontekstu, które tradycyjne skanery generują tysiącami. To właśnie te wykrycia przytłaczają zespoły ds. bezpieczeństwa pracą związaną z klasyfikacją zgłoszeń i podważają zaufanie do samych narzędzi.
Jednak 45 z tych wykrytych problemów stanowiło rzeczywiste luki w zabezpieczeniach. Jedna z nich miała charakter krytyczny.
Krytyczne wykrycie: Nasz silnik AI wykrył krytyczną lukę w zabezpieczeniach, którą tradycyjne skanery uznałyby za „czysty kod”. Kod wyglądał na poprawny pod względem składniowym, przeszedł kontrolę lintingową i był zgodny z powszechnymi wzorcami — jednak jego logika umożliwiała wykorzystanie luki.
Czego nie wychwytują tradycyjne skanery
Oto niewygodna prawda dotycząca konwencjonalnych narzędzi bezpieczeństwa: są one zaprojektowane tak, by wykrywać to, co już znają. Wzorce wyrażeń regularnych, znane sygnatury CVE, sprawdzanie wersji bibliotek. Są one niezbędne, ale nie wystarczające — zwłaszcza gdy kod generowany przez sztuczną inteligencję wprowadza nowe wzorce, które nie pasują do żadnego istniejącego zestawu reguł.
Nasz silnik wykrył klasy podatności, które tradycyjne skanery konsekwentnie pomijają:
Ominięcia uwierzytelniania
Ścieżki logiczne, w których występowały mechanizmy uwierzytelniania, ale były one strukturalnie nieskuteczne — poprawnie zaimplementowane moduły pośredniczące, nieprawidłowa kolejność wykonywania, warunki wyścigu, które można było wykorzystać.
⚡
Błędy w logice biznesowej
Kod, który przechodzi wszystkie testy lintera i skanera, ale zawiera sprzeczności logiczne, które osoba atakująca mogłaby wykorzystać do eskalacji uprawnień lub manipulacji stanem.
🔗
Wzorce przejęcia sesji
Drobne słabe punkty w obsłudze sesji — przewidywalne tokeny, niewystarczające unieważnianie, nieprawidłowe powiązania — które stwarzają okazje do przejęcia kontroli nad sesją.
Są to błędy, które na pierwszy rzut oka wyglądają na poprawny kod, dopóki nie ujawnią się. Przechodzą kontrolę kodu. Przechodzą przez CI. Trafiają do środowiska produkcyjnego. I tam czekają.
Trzy skanowania. Jeden raport. Pełna przejrzystość.
CyberTested Code to nie kolejny skaner dodany do Twojego procesu. To silnik bezpieczeństwa oparty na sztucznej inteligencji, stworzony od podstaw tak, by rozumieć kod tak samo jak atakujący — w kontekście, całościowo i kreatywnie.
Każde skanowanie generuje ujednolicony raport obejmujący trzy odrębne rodzaje analiz, którego celem jest zapewnienie Twojemu zespołowi pełnego wglądu w to, co faktycznie dzieje się w Twoim kodzie źródłowym. Nie jest to zalew alertów ani arkusz kalkulacyjny z listą luk CVE. Jest to uszeregowana według priorytetów i osadzona w kontekście ocena rzeczywistego ryzyka.
Stosunek sygnału do szumu ma znaczenie. Gdy 900 z 945 wyników to szum, nie potrzebujesz większego strumienia danych — potrzebujesz filtra, który naprawdę działa. Właśnie taki stworzyliśmy.
Stworzone z myślą o erze programowania Vibe
Jeśli tworzysz oprogramowanie z wykorzystaniem sztucznej inteligencji, wprowadzasz je na rynek szybciej niż kiedykolwiek. Twoje procesy weryfikacji kodu zostały zaprojektowane z myślą o tempie pracy typowym dla ludzi. Twoje narzędzia bezpieczeństwa zostały stworzone z myślą o bazach kodu, które rosną stopniowo, a nie wykładniczo.
CyberTested Code powstał z myślą o tej nowej rzeczywistości. Jest przeznaczony dla zespołów, które działają szybko i muszą wiedzieć — z całą pewnością, a nie na podstawie domysłów — co faktycznie kryje się w kodzie, który wprowadzają na rynek.
Nie prosimy was, żebyście zwolnili. Prosimy was, żebyście dobrze widzieli, nawet gdy poruszacie się z dużą prędkością.

